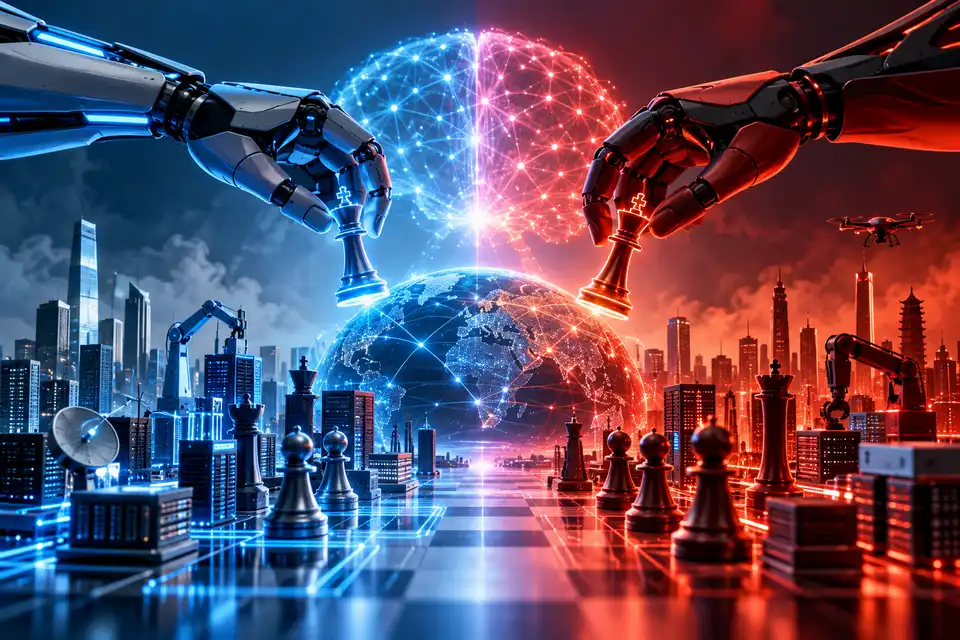
Китайските разработчици DeepSeek и Moonshot AI са използвали активно изходни данни от модела GPT-6 Astra на американската компания OpenAI, за да обучат собствените си нови системи с изкуствен интелект. Процесът, известен като „дестилация“, позволява възможностите на по-мощни модели да бъдат пренесени в други системи.
Данни от GPT-6 Astra са били използвани за обучението на модела Kimi K3.1 Pro на Moonshot AI (пуснат миналата седмица), както и на обновения DeepSeek V4.1-Flash 1017, който излезе на 17 октомври, според публикация на The Information.
Дестилацията включва използването на отговори, генерирани от по-мощен модел, за обучение на друга система. Процедурата позволява на втората система по-бързо да възпроизведе специфични възможности на изкуствения интелект, без да са необходими значителните разходи за разработка, които иначе биха били нужни.
Използването на подобни техники се превърна в предмет на спорове сред водещите компании в сферата на изкуствения интелект. OpenAI, Anthropic и Google твърдят, че дестилацията позволява на конкурентите бързо да копират възможностите на техните модели, без да правят съответните инвестиции.
В публикация от 30 септември OpenAI заяви, че е идентифицирала субекти – за които се твърди, че са свързани с Moonshot AI – участвали в кампания за събиране на данни, започнала през юли. Представители на OpenAI, DeepSeek и Moonshot AI не отговориха на запитванията за коментар от страна на агенция Ройтерс.
Дестилацията не е непременно нелегитимна техника
Дестилацията е утвърден метод в машинното обучение. Тя се използва и от самите OpenAI и Anthropic, когато разработват по-малки и по-икономични версии на собствените си модели. При нея т.нар. модел-учител генерира отговори на множество задачи, а модел-ученик се обучава върху тези резултати, за да усвои определени способности.
Това не означава, че се копира целият модел. Не се прехвърлят автоматично неговите параметри, архитектура или обучителен код. Пренасят се модели на поведение, знания, начини за решаване на задачи и характерни особености на генерираните отговори.
Проблем възниква, ако процесът се осъществява без разрешението на разработчика, в нарушение на условията за използване, чрез мащабно автоматизирано извличане на данни или чрез опити за разкриване на защитени вътрешни механизми.
Именно такова поведение OpenAI описва в своя публикация си от 30 септември 2026 г. Компанията съобщава за координирана кампания, започнала през юли, при която са правени опити за извличане на защитени логически разсъждения от моделите ѝ. OpenAI свързва част от дейността с лица, асоциирани с Moonshot AI.
Къде е границата между иновация и присвояване
В науката и технологиите рядко някой разработва всичко „от нулата“. Изследователите използват публикувани научни трудове, отворен код, публични набори от данни и резултати от предишни разработки. Конкуренцията винаги е включвала учене от постиженията на останалите.
Ученето чрез публично достъпни знания обаче е нещо различно от използването на чужда платена услуга, за да се извличат систематично резултатите от скъп, вече разработен модел, заобикаляйки ограниченията му.
Възниква и друг потенциален проблем – безопасността. Ако един модел усвои способностите на друг, без да усвои същите механизми за контрол, тестване и ограничаване на рисковото поведение, може да се получи система с големи възможности, но с по-слаби защитни механизми. Anthropic изрично посочва този риск в свой анализ си за т. нар. дестилационни атаки.
Потенциални последици
Какво означава случващото се за бъдещето на AI индустрията? Според анализаторите, можем да очакваме:
Промяна в конкурентната стратегия: компаниите вече ще трябва да защитават не само моделите си, но и начина, по който те взаимодействат с потребителите. Всеки отговор може да се превърне в обучителен материал за конкурентна система.
По-голямо значение на собствените модели и данни: разработчиците ще търсят начини да ограничават масовото автоматизирано извличане на информация, да разпознават подозрителни модели на употреба и да защитават вътрешните механизми на своите системи.
Натиск върху цените и бизнес-моделите: ако дестилацията позволява на повече компании да създават способни модели с по-малко инвестиции, това може да ускори конкуренцията, да понижи цените на AI услугите и да направи мощните модели по-достъпни.
Превръщане на AI в нов фронт на технологическата война: досега основните инструменти на технологическото съперничество бяха ограниченията върху износа на чипове, санкциите, контролирането на инвестициите и достъпът до специализирано производствено оборудване. Но сега към тях може да се добави нов инструмент: ограничаване на достъпа до интелектуалните възможности на AI моделите. Сред мерките, които е възможно да се разгърнат, са:
- ограничаване на достъпа до най-мощните модели за определени държави и организации;
- по-строг контрол върху API достъпа и автоматизираното извличане на отговори;
- санкции срещу компании, обвинени в индустриализирано извличане на чужди AI способности;
- ограничаване на достъпа до облачни услуги, които предоставят изчислителни ресурси на санкционирани организации.
Последното не е само хипотетичен сценарий в бъдеще време. На 8 септември 2026 г. CISA, NSA и FBI публикуваха съвместно предупреждение, в което обвиниха редица китайски AI компании, включително DeepSeek и Moonshot AI, в мащабни кампании за извличане на способности от американски модели. Американските агенции препоръчват координирани защитни мерки и обмен на информация между разработчиците.


