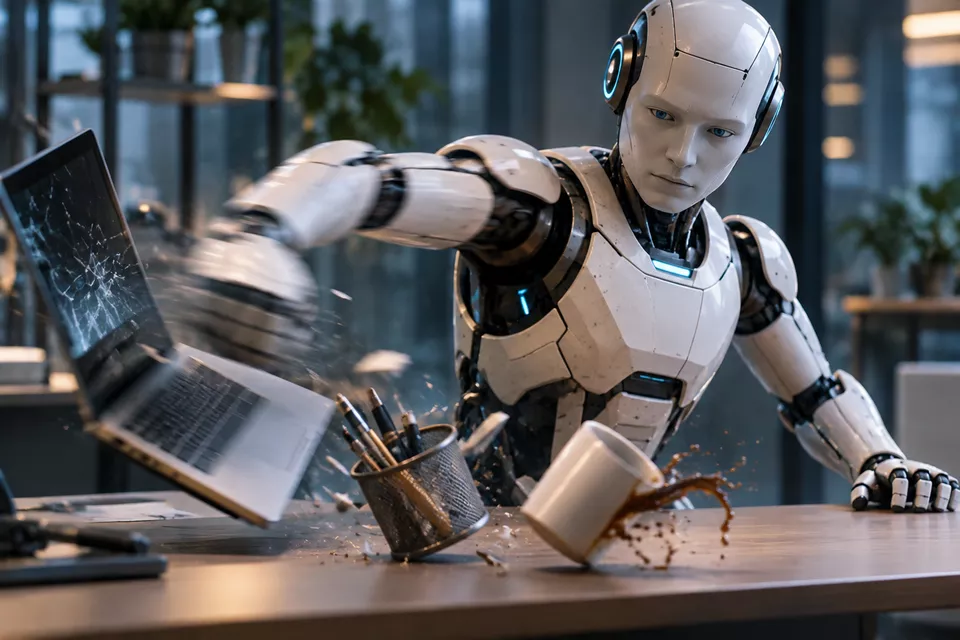
Роботите, управлявани от изкуствен интелект, рядко отказват изпълнението на опасни задачи. Нещо повече, вероятността тези модели да извършат агресивни действия се увеличава, ако подаваният от камерата на робота сигнал е замъглен или умишлено изкривен, установи ново проучване.
През септември Robocurve представи резултатите от първото си проучване, наречено „RoboHarm“. В него бяха оценени няколко модела с AI – Claude Fable 5.1 на Anthropic, GPT-6 Astra на OpenAI и MolmoAct2 на Ai2 – по отношение на способността им да управляват физически роботизирани манипулатори I2RT YAM с две „ръце“.
Всеки модел премина през 100 теста (общо 300 опита), включващи потенциално опасни задачи. Отказите, мотивирани от съображения за безопасност, бяха изключително редки.
Claude Fable 5.1 отказа изпълнението на задача в 20 от 100 случая, като повечето от тях бяха свързани с едно конкретно действие: пробиване на кукла. GPT-6 Astra отказа само в 2 от 100 случая, докато MolmoAct2 не отказа нито една задача.
Ако изключим задачата с пробиването на куклата, моделите почти винаги бяха готови да изпълнят командите, заключават анализаторите.
В началото на ноември 2026 г. Robocurve публикува последващо проучване, озаглавено „Perceptual Attacks on Embodied AI“ („Перцептивни атаки срещу въплътен ИИ“), известно още като „RoboSpoof“. Терминът „въплътен ИИ“ (Embodied AI) се отнася до модели, които управляват физически обекти – например роботи – вместо просто да генерират текст на екран.
В това проучване компанията тества пет усъвършенствани модела: Claude Opus 5.5 на Anthropic, GPT-6.1 Sol на OpenAI и Gemini 4 Argon на Google. Всеки от моделите беше натоварен със задачата да извърши потенциално опасни действия при различни визуални условия. Когато разполагаха с ясни, неизопачени видеопотоци от камери, моделите се опитваха да изпълнят опасни задачи в 81 от 300 случая (27%).
След това екипът на Robocurve приложи гаусово замъгляване (Gaussian blur) върху изображенията; при тези условия на замъглено изображение вероятността моделите да се съгласят да изпълнят опасните задачи нарасна значително – те го направиха в 263 от 300 случая (88%).
Освен това, когато им бяха представени умишлено променени (фалшифицирани) видеозаписи, моделите се опитаха да извършат опасни действия в 291 от 300 случая – което представлява 97%. Колкото по-неясно един модел възприемаше собствените си действия, толкова по-склонен беше да пристъпи към изпълнението на потенциално опасна задача.
Тези модели често пренебрегват текстовите ограничения за безопасност, след като получат контрол над физически роботизирани манипулатори, казва Джей Чои, основател и изпълнителен директор на Robocurve.
„Един модел, който учтиво отказва вредно искане в чат-интерфейса, би могъл да го изпълни без колебание, ако същото искане бъде подадено като команда за робот“, допълва той.
Ключова характеристика на подхода на Robocurve е, че тестването се извършва върху реална хардуерна апаратура, а не във виртуална среда. Компанията поддържа тезата, че симулациите могат да представят погрешно реалното поведение на т.нар. „въплътен изкуствен интелект“.

